Meio dia de tempo de internação vale 26 leitos
O dataset Iris foi onde aprendi PCA, k-means e as três espécies: setosa, versicolor, virginica. Quatro medidas, 150 linhas, e um gráfico que separa quase perfeitamente se você forçar um pouco a vista. É provavelmente onde muita gente viu pela primeira vez a ideia que sustenta machine learning, que não é bem sobre o algoritmo. Você define um objetivo, escreve um custo, e sai procurando os parâmetros que fazem esse custo diminuir.
Aprendi isso durante o meu mestrado no Brasil, num programa que ensinava os fundamentos num nível que ainda uso hoje. O MATLAB era a espinha dorsal do curso, e com razão. É um ambiente sério, com décadas de trabalho numérico validado por trás, e as pessoas que me ensinaram construíram carreiras em cima dele. O que eu não tinha era acesso. Não havia licença universitária, e comprar uma por conta própria não era uma conversa que eu ia ter comigo mesmo naquela idade. Eu já rodava Linux, então fui atrás da coisa mais próxima que conseguia instalar naquela semana e cheguei ao GNU Octave. Os mesmos arquivos .m, a mesma semântica de matrizes, e o curso continuava funcionando. Achei que tinha deixado aquilo para trás, arquivado junto com a tese. Três semanas atrás instalei de novo, e não foi por nostalgia.
A frase que encerra a conversa
Uma versão da mesma conversa acontece na área de saúde a cada poucos meses. Alguém descreve uma pergunta de modelagem que nunca teve tempo de rodar. Quantos leitos a gente realmente precisa em janeiro. Quão cedo poderíamos ter percebido que aquele paciente estava piorando. Aí a conversa para, e para sempre nos dois mesmos pontos: as licenças teriam que passar pelo setor de compras, e os dados exigiriam um pedido de acesso. Nenhum dos dois é um problema técnico. Os dois são problemas de calendário, e meses é tempo suficiente para a pergunta deixar de importar para quem a fez.
Os dois agora têm um atalho que não existia quando eu escrevia código de tese, e cada um é bom o suficiente para a passada exploratória em que você ainda está decidindo se a pergunta merece um projeto de verdade. O Octave é gratuito e roda a mesma linguagem que eu já conheço. E dados sintéticos de pacientes ficaram bons o suficiente para modelar em cima. O Synthea gera históricos completos de pacientes sintéticos que não contêm PHI, o que significa que um extrato pode ficar num repositório público e você pode clonar numa tarde de terça-feira. Usei o mesmo gerador para a skill de conformidade FHIR algumas semanas atrás, exatamente por esse motivo.
Então construí o samueltauil/octave-care-analytics, que acabei chamando de Care Traffic Control. Dois modelos de operações hospitalares em Octave puro, comandados ao vivo por um painel de canvas do GitHub Copilot com sliders, enquanto um agent lê os mesmos números que você está olhando.
Este é, na verdade, a segunda metade de um par, e a primeira metade foi na direção totalmente oposta. Lá em julho construí um gêmeo digital cardíaco em MATLAB e Simulink, comandado pelo Copilot via MCP, e ainda é o projeto do qual mais me orgulho este ano. Um modelo cardiovascular de malha fechada validado de um paciente, cinco subsistemas incluindo um loop de feedback barorreflexo, e um agent interrogando uma sessão Simulink ao vivo em oito prompts em linguagem natural em vez de editar um script no disco. Aquele modelo justificou a licença várias vezes. Você não monta fisiologia garantida por solver a partir de arquivos .m soltos e boas intenções. O que eu queria testar desta vez era a outra ponta do mesmo espectro: sem licença, sem toolboxes, sem pedido de dados, e uma pergunta que alguém precisa responder ainda esta semana.
A primeira versão respondia a uma pergunta chata
Minha primeira tentativa foi uma demo sobre o Octave. Ela renderizava uma figura, a figura aparecia num painel de canvas, você podia mudar um parâmetro e ver o redesenho. Funcionou já na segunda noite e eu não gostei. Respondia a uma pergunta que ninguém está fazendo, que é se o Octave consegue desenhar um gráfico. Reconstruí tudo em torno de duas perguntas hospitalares e não sobrou quase nada daquela versão, exceto o worker process.
A modelagem também teve uma falsa partida, e essa mais interessante. O tempo de internação é o input do qual tudo mais depende, e a tentação é ajustar uma exponencial a ele. Um parâmetro, limpo, fácil de explicar num slide. Só que isso achata a cauda direita, e a cauda direita é o problema inteiro. A maioria dos pacientes vai para casa rápido. Um número pequeno de pacientes complexos fica internado por semanas, e são esses que lotam a ala em fevereiro. Então a simulação reamostra das 1.807 internações reais no extrato do Synthea e reescala essa distribuição empírica para qualquer média que você esteja testando. A forma permanece medida. Só a média vira o cenário.
Por que ele vive no Copilot app
A coisa toda foi construída para rodar dentro do GitHub Copilot app, o aplicativo desktop que o GitHub oferece para trabalho conduzido por agents. É uma superfície separada da extensão do editor e do CLI. Você aponta ele para um repositório ou uma pasta local, roda sessões de agent em cima disso, e cuida do pull request resultante sem sair da janela.
O que fez dele o host certo aqui foram as canvas extensions. Um canvas é um painel que o app abre ao lado da conversa, e o próprio repositório declara o que vai dentro dele. O meu tem cerca de 700 linhas de JavaScript em .github/extensions/octave-canvas/. Ele sobe o worker do Octave, pede uma renderização e desenha os sliders e a faixa de métricas em volta da figura que volta. Como está commitado junto com os modelos, qualquer pessoa que abrir essa pasta no app recebe o mesmo painel, sem nada para instalar e sem nenhum serviço hospedado em lugar nenhum.
O resto do repositório se apoia na mesma ideia. .github/skills/octave-portability/ é uma skill que conhece as regras do Octave sem pacotes extras e as restrições de gráficos sem interface gráfica, que são genuinamente difíceis de descobrir sozinho. .github/agents/octave-reviewer.md é um custom agent que revisa os números e a portabilidade e deixa a formatação de lado. Nada disso é configuração parada no meu laptop. Está versionado junto com o código que governa, e essa é a parte que eu manteria mesmo se jogasse fora todo o resto.
Meio dia de tempo de internação
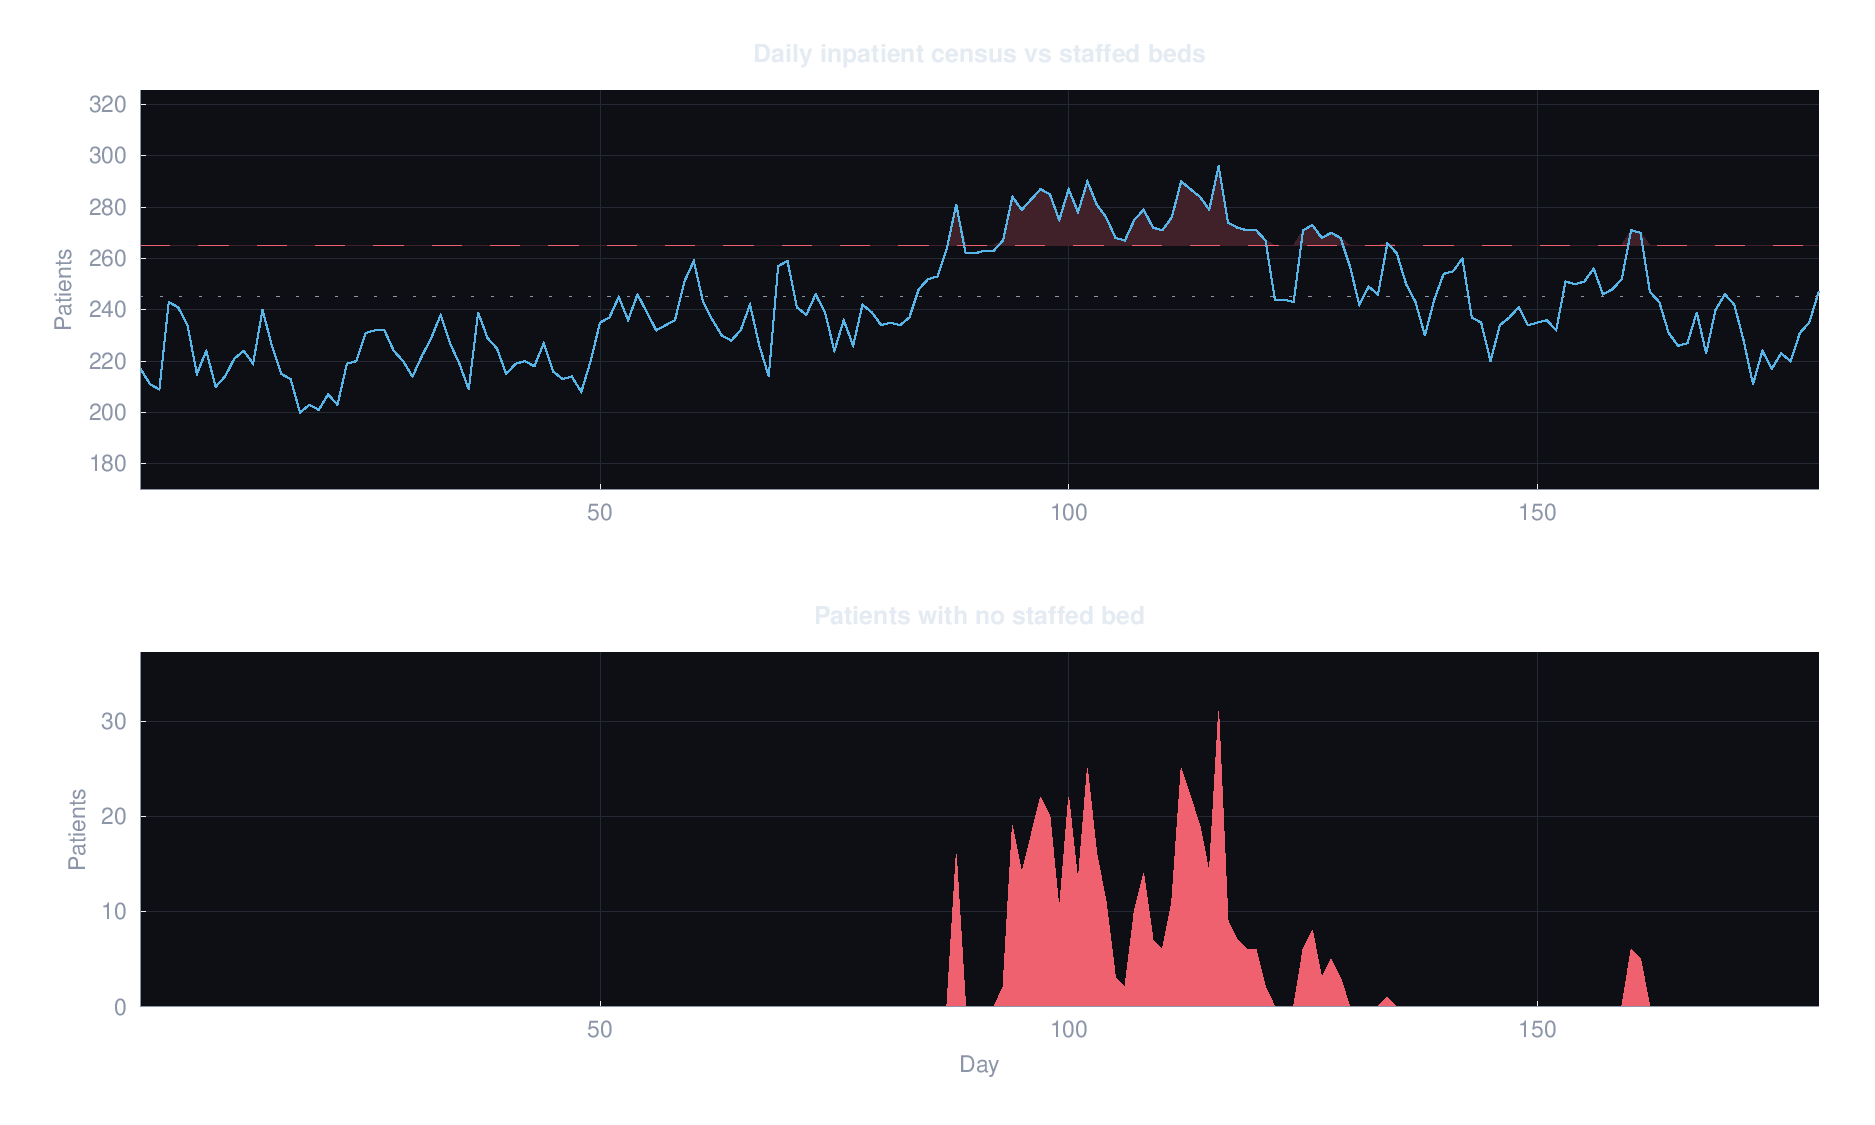
O modelo de capacidade é um censo diário com chegadas de Poisson e um pico sazonal por cima. Os primeiros 150 dias simulados são descartados para que você esteja olhando para o estado estacionário em vez de um artefato de aquecimento. Os padrões são 265 leitos com equipe, 45 admissões por dia, tempo médio de internação de 4,8 dias e um pico de inverno de 25%.
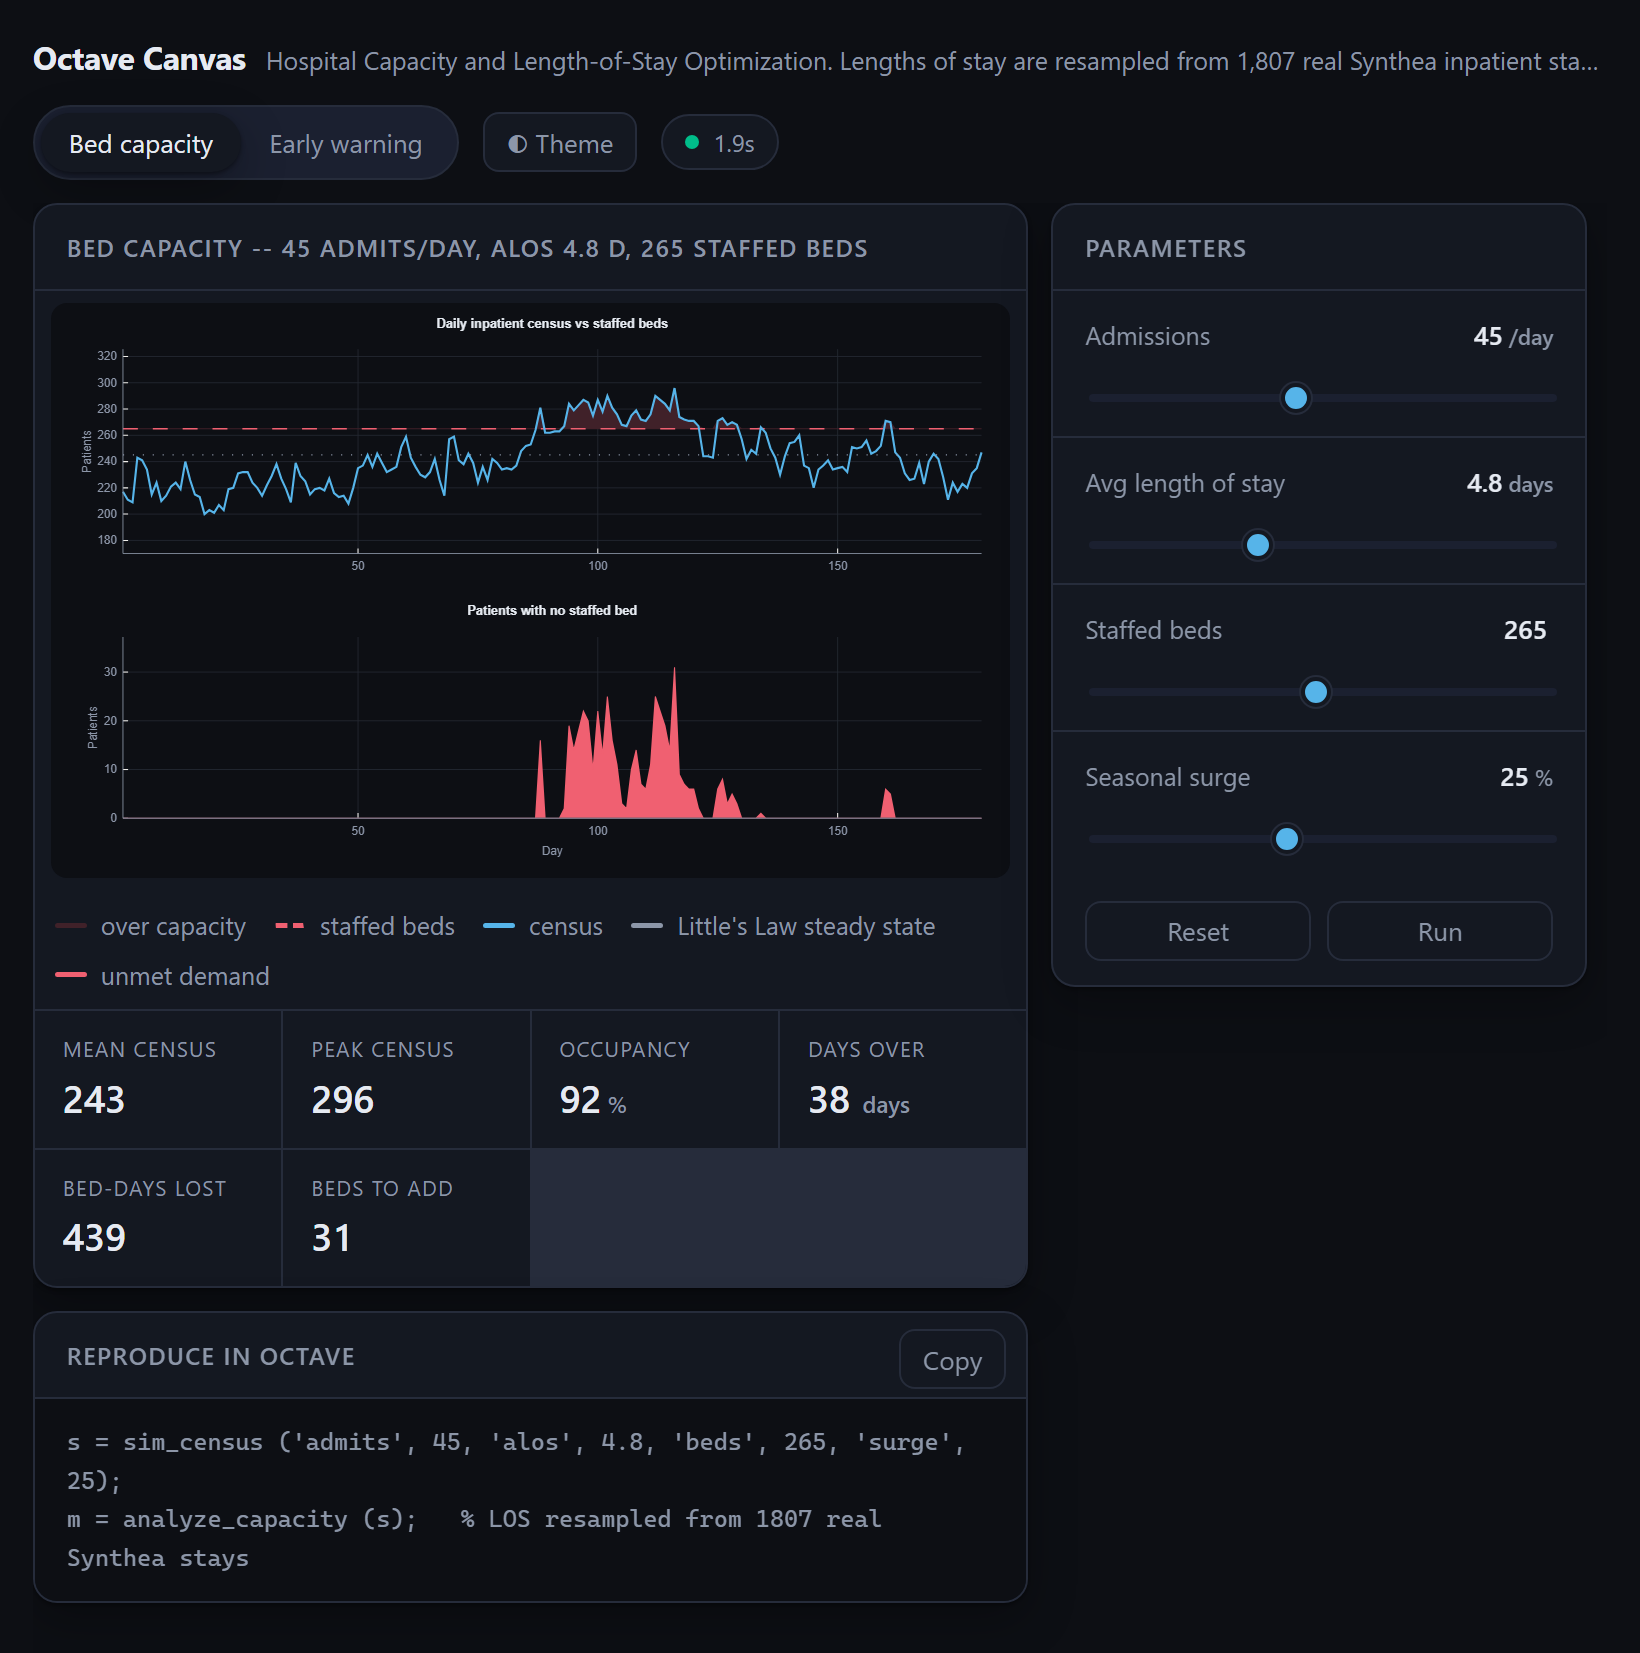
Depois você arrasta o slider de tempo de internação para 4,3 e espera cerca de um segundo.
| Tempo médio de internação | Censo médio | Ocupação | Dias acima da capacidade | Leitos-dia perdidos |
|---|---|---|---|---|
| 5,4 | 273 | 103% | 97 | 2.557 |
| 4,8 | 243 | 92% | 38 | 439 |
| 4,3 | 217 | 82% | 0 | 0 |
Meio dia de tempo de internação valia cerca de 26 leitos e todos os dias do transbordo de inverno. A Lei de Little te leva quase até lá num guardanapo, porque o censo médio é aproximadamente admissões por dia vezes o tempo médio de internação, então com 45 admissões por dia um dia inteiro vale cerca de 45 leitos. A simulação ficou um pouco acima do número do guardanapo para o meio dia, já que o pico não se equilibra tão educadamente na média. O que importa é a direção. Isso não é um programa de construção de leitos, é um programa de planejamento de alta, e são conversas orçamentárias muito diferentes.
E corta na outra direção com a mesma rapidez. Seis décimos de dia na direção errada e você fica acima da capacidade por cerca de um terço do ano.
A parte que torna isso mais do que um gráfico bonito é que o painel e o agent compartilham um único estado. Se eu arrasto um slider, o agent consegue ler onde eu deixei. Quando pergunto “se não pudermos mudar o tempo de internação, quantos leitos precisamos para aguentar um pico de 40%”, ele chama get_model, lê os números que estão na tela naquele momento, ajusta via set_params e responde a partir da execução que ele acabou de produzir em vez de estimar. Essa ordem é a única regra que eu passaria para quem for construir esse tipo de painel. O agent tem que ler o estado antes de raciocinar sobre números, porque o humano moveu um slider enquanto ele estava falando.
Por que a média móvel precisa olhar para trás
O segundo cenário são 24 horas de um paciente, amostradas a cada cinco minutos. Os sinais vitais em repouso são uma linha real do extrato base do Synthea de 1.456 pacientes. A telemetria de alta frequência sobreposta é simulada, porque o Synthea não produz dados de monitoramento contínuo e prefiro dizer isso do que dar a entender o contrário. Uma deterioração parecida com sepse começa na hora 14.
Cada amostra é pontuada com o NEWS2, o que vale a pena explicar caso você nunca tenha esbarrado nisso. A sigla vem de National Early Warning Score 2, uma tabela de pontuação de beira de leito publicada pelo Royal College of Physicians e usada em todo o NHS e bem além dele. Cada sinal vital ganha pontos com base em quão longe da faixa normal ele está, e os pontos somam um único número entre 0 e 20 que diz a uma ala quão preocupada ela deveria estar. Essa implementação pontua frequência respiratória, saturação de oxigênio, pressão sistólica, pulso e temperatura. O atrativo para uma simulação como essa é que a tabela é pública, fixa e sem graça, então nada no comportamento de alerta depende de um modelo que eu inventei.
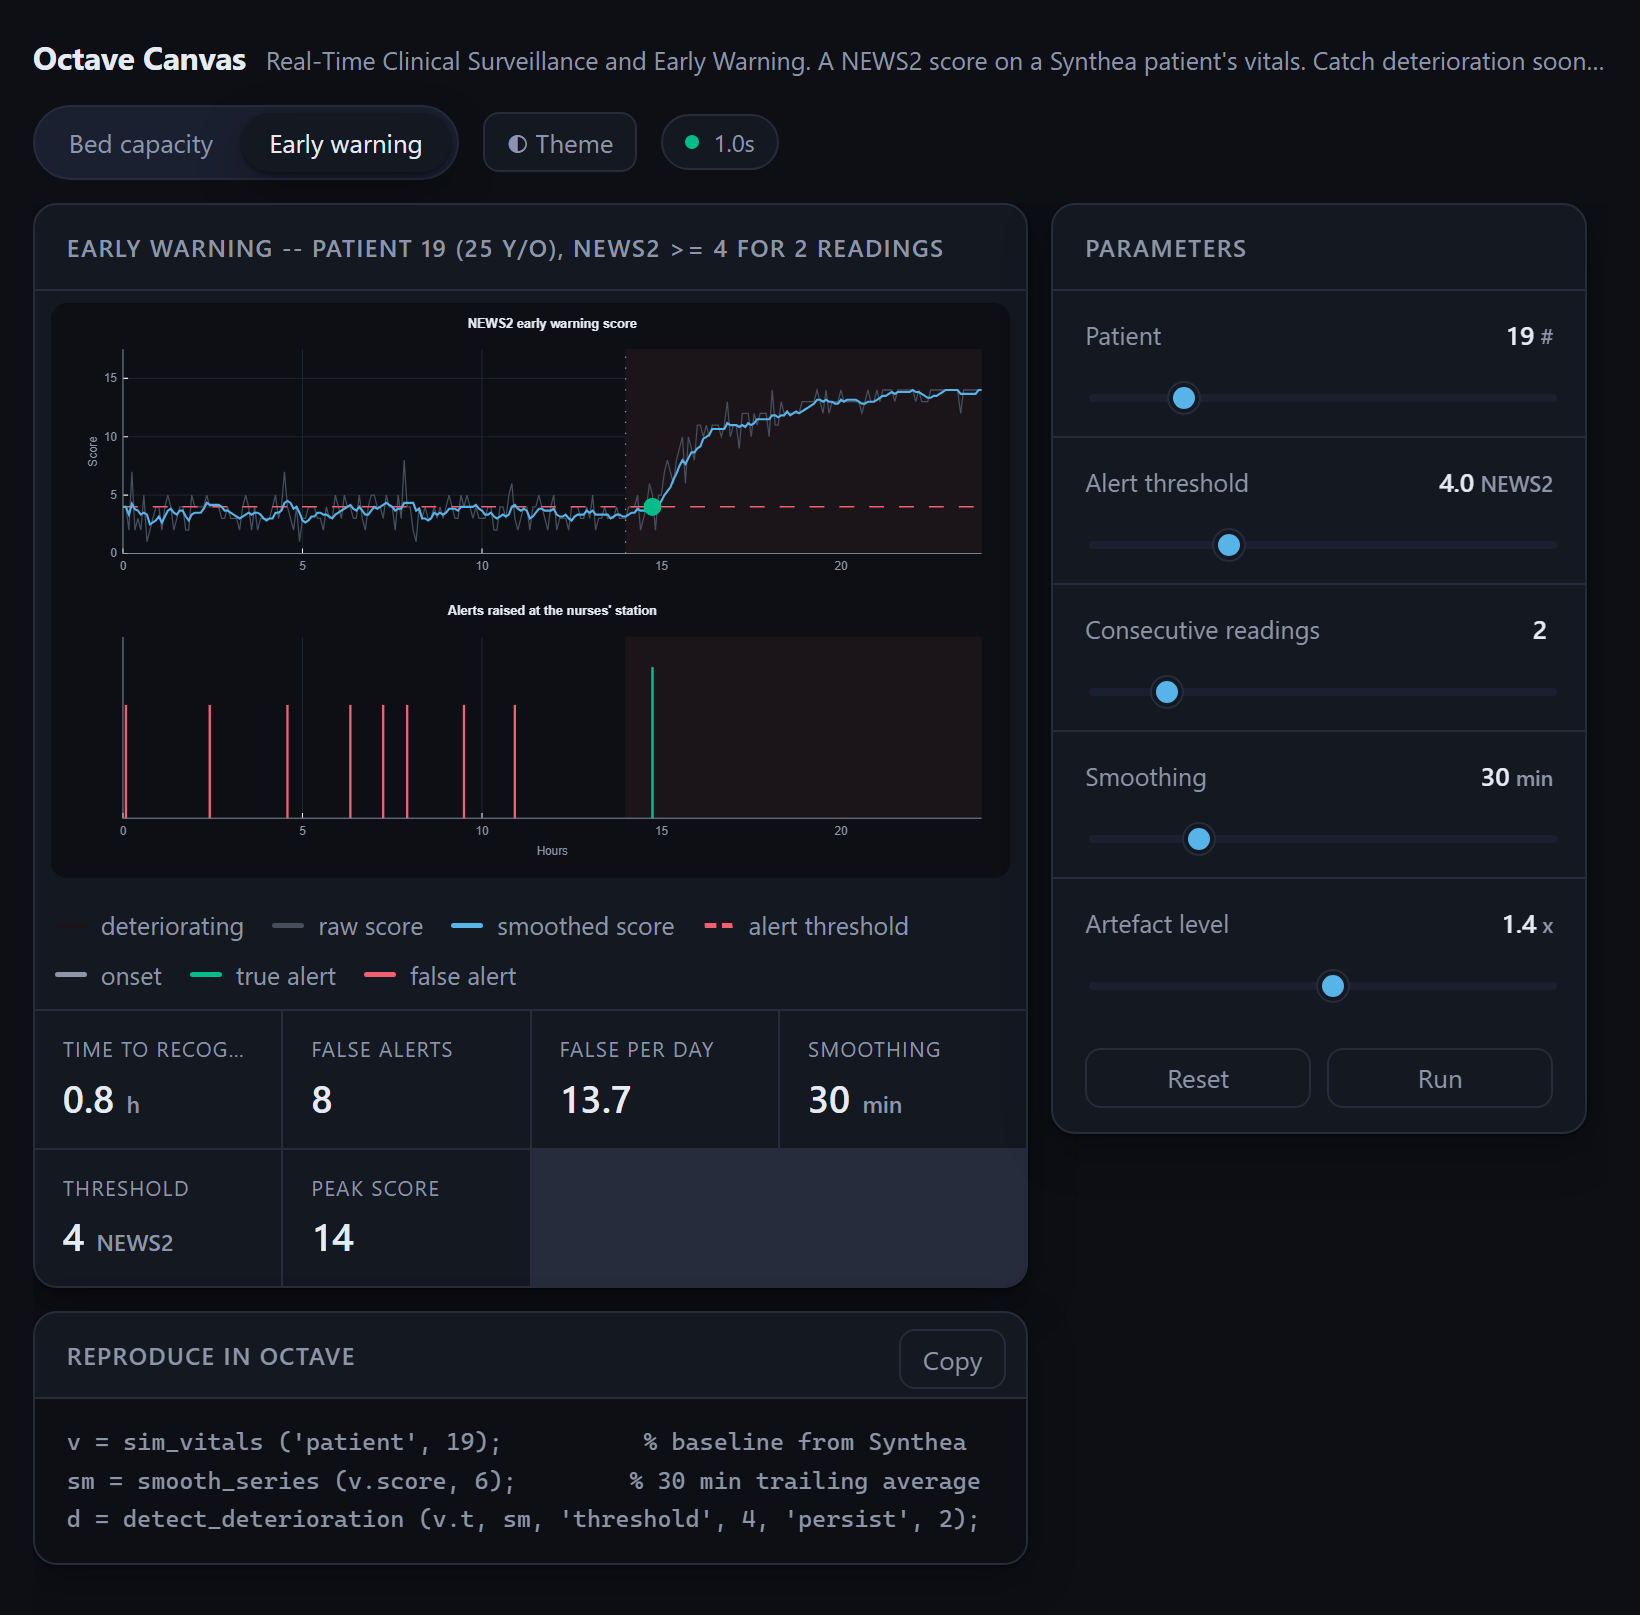
A regra de alerta é um limiar mais persistência, suavizada com uma média móvel, e essa média móvel precisa ser retroativa. Não centrada. Uma janela centrada no instante t faz a média de amostras dos dois lados de t, o que significa que o detector está discretamente lendo o futuro. Um monitor de beira de leito não pode fazer isso. Centralize a janela e seu sistema de alerta precoce vai pontuar quase tão bem quanto um sistema que já sabe que o paciente piorou. Então, quando um modelo de série temporal tem um desempenho suspeitosamente bom offline, a primeira coisa que verifico hoje é para que lado a janela aponta.
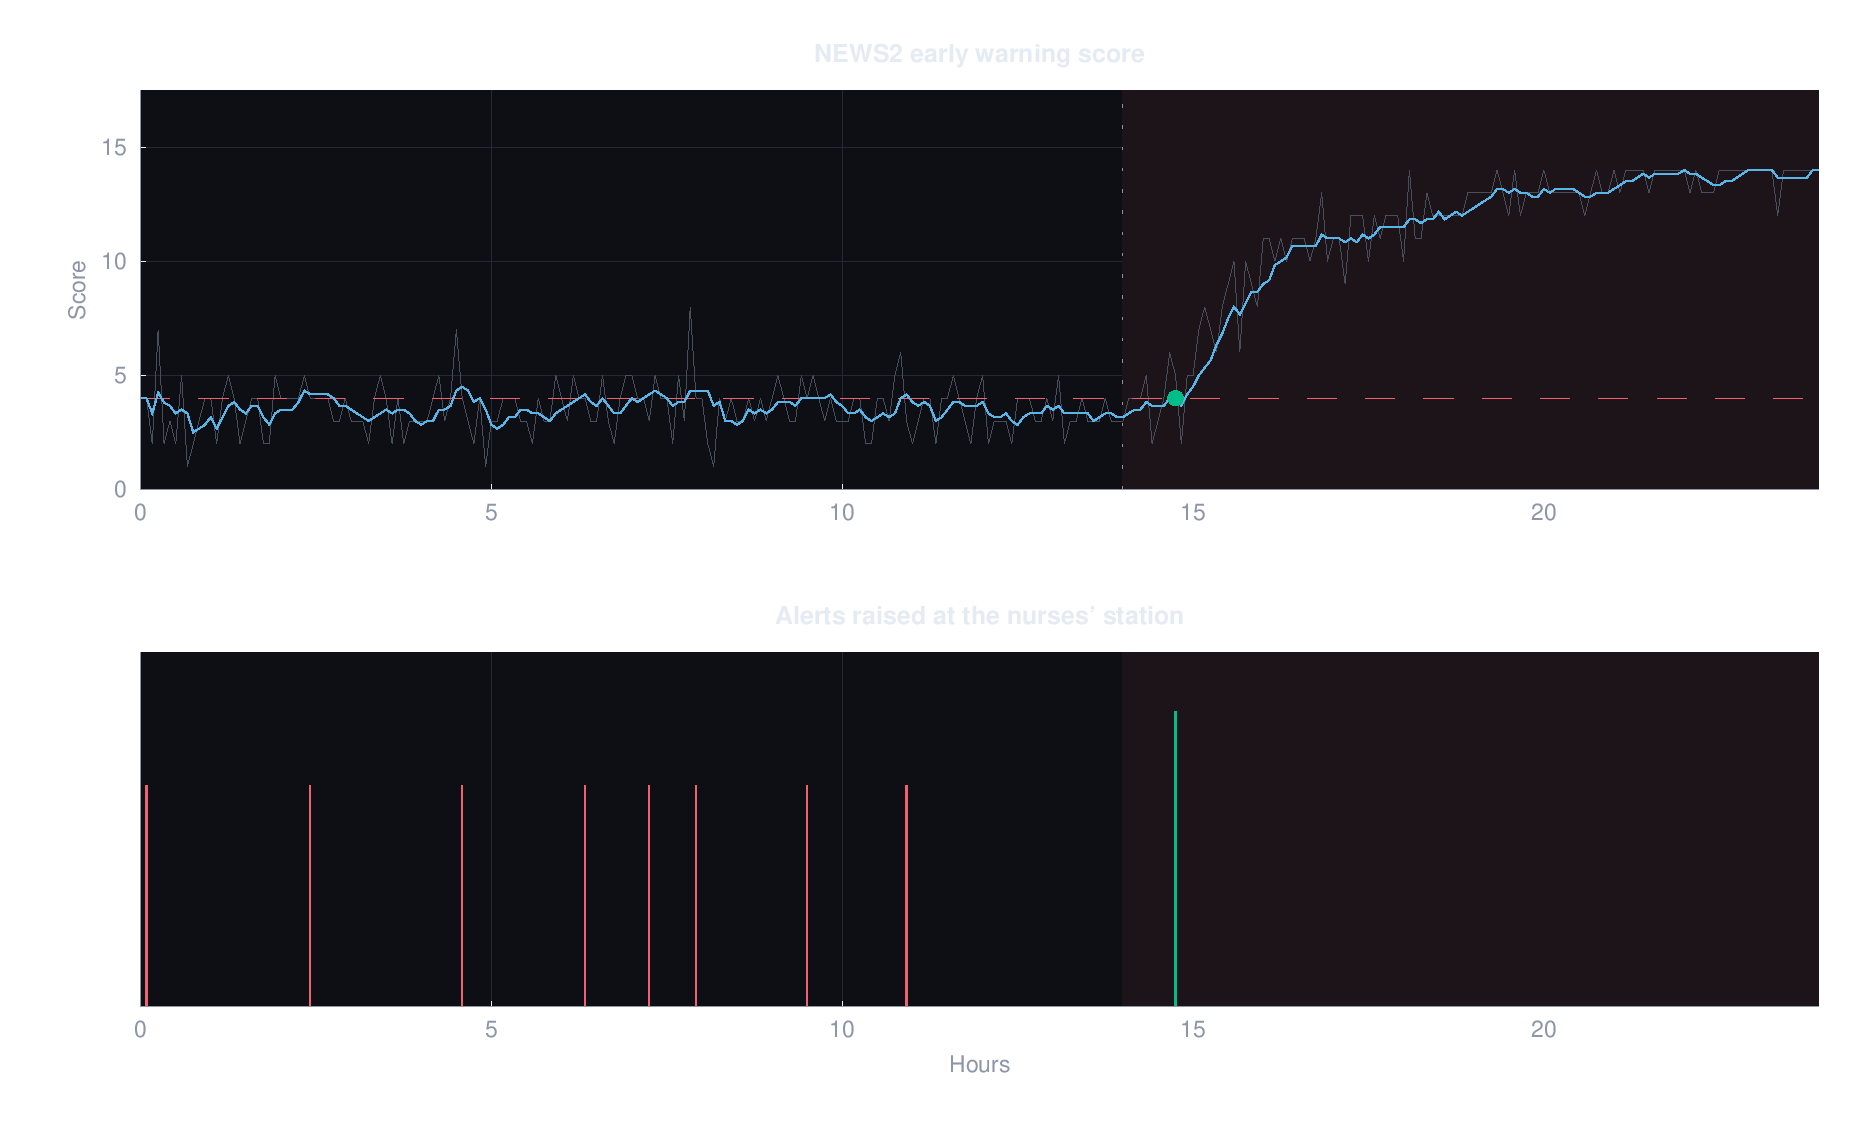
Com o limiar em 4, o painel mostra oito alertas falsos antes do início e uma detecção verdadeira 45 minutos depois. Subindo para 5, os alertas falsos vão a zero, enquanto o tempo de reconhecimento se estende para 1,17 horas. Baixando para 3, que fica abaixo da própria pontuação de repouso desse paciente em particular, o alarme simplesmente nunca desliga, então não carrega informação nenhuma.
Cada um desses oito traços vermelhos é uma enfermeira caminhando até uma cama à toa. Fadiga de alerta é o motivo de sempre pelo qual as alas param de confiar nesses sistemas, e nenhuma configuração naquele painel evita essa troca. Vinte e cinco minutos extras compram uma ala que ainda acredita no alarme. Se isso é um bom negócio é um julgamento clínico, não de engenharia. O que o canvas faz é colocar o preço da escolha na tela em vez de escondê-lo num valor padrão.
O que os testes verificam
A suíte tem 67 asserções e nenhum framework, e o CI é apt install octave num runner comum. O código evita completamente os pacotes signal, control e statistics, então o amostrador de Poisson, a tabela NEWS2, a média móvel e a reamostragem empírica são todos escritos à mão. Isso dá mais trabalho do que importá-los, e é o motivo pelo qual a coisa toda se instala em uma linha em qualquer máquina, incluindo um laptop hospitalar travado. As duas figuras de cenário também renderizam sem interface gráfica nesse runner e sobem como artifacts de build, então a execução que prova os números é a mesma que produz as imagens.
Mais útil do que a contagem: os testes verificam os achados, não só o encanamento. A Lei de Little é checada com margem de 8%. A troca de fadiga de alerta é verificada nas duas direções, então uma mudança que destrói silenciosamente o argumento quebra o build em vez de produzir um gráfico mais bonito. Confio muito mais nisso do que num snapshot test em cima de um SVG.
Dois detalhes nos quais eu não esperava gastar tempo. O commit menos glamouroso do repositório instala fontes no CI, porque o Octave sem interface gráfica não consegue construir eixos num runner nu e falha com ft_text_renderer: invalid bounding box, que não é uma mensagem de erro que te conta que o container não tem fontes. E o toolkit gnuplot descarta silenciosamente as legendas do Octave, então o Octave renderiza só os dados num SVG com tema, e o painel desenha o título, os chips de legenda e a faixa de métricas em HTML ao redor. Eu adoraria dizer que essa separação foi uma decisão de design limpa sobre texto nítido e temas. Foi metade isso e metade o gnuplot não me dando escolha.
Aqui está o que o Octave entrega sozinho, antes do painel desenhar qualquer coisa ao redor.
Por baixo do painel, src/oc_serve.m é um worker residente que fica consultando um diretório de mailbox em busca de requisições JSON e escrevendo respostas JSON de volta, o que mantém o interpretador aquecido. Uma renderização aquecida leva cerca de um segundo, uma fria leva quatro. Essa diferença é o motivo inteiro pelo qual arrastar um slider parece usar um instrumento em vez de disparar um build.
git clone https://github.com/samueltauil/octave-care-analytics
cd octave-care-analytics
bash scripts/setup.sh
octave-cli --no-gui --norc --quiet examples/01_capacity_planning.m
Os dois cenários rodam de forma independente a partir de um shell, então você consegue ler os números sem nunca abrir o canvas. Há um WALKTHROUGH.md com tempos, caso você queira demonstrar isso para alguém.
Por que mantenho os dois caminhos abertos
Vinte anos atrás eu rodava Octave porque era o que eu conseguia ter. Três semanas atrás escolhi ele num laptop que poderia rodar qualquer coisa, porque eu queria que esse repositório fosse algo que um estranho pudesse clonar e ter rodando em cinco minutos. O código .m aqui também roda no MATLAB, com duas pequenas mudanças: tirar a chamada new_figure.m que força o toolkit gnuplot, e ignorar parse_opts.m, que faz as vezes de inputParser. Manter esse caminho funcionando quase não me custa nada, e significa que uma equipe que já tem MATLAB pode levar isso para o próprio ambiente e ganhar as toolboxes, o histórico de validação e o contrato de suporte que o Octave nunca tentou oferecer.
Eu não colocaria esse modelo na frente de um regulador, e não pediria para o Simulink ser algo que um estranho clona em cinco minutos. O gêmeo cardíaco e este são respostas a perguntas diferentes, construídos com um par de meses de diferença, e eu não trocaria um pelo outro. O que eles têm em comum é a interface. Nos dois casos o Copilot comanda um modelo numérico que ele não escreveu e não consegue forjar, lê o estado que aquele modelo realmente produziu e reporta a partir disso em vez de estimar. Trocar o Simulink pelo Octave mudou quase tudo em como o modelo é construído e quase nada em como ele é comandado.
O que fico revisitando é o quão pouco da dificuldade jamais foi técnica. A matemática neste repositório é matemática de graduação. Lei de Little, chegadas de Poisson, uma tabela de pontuação publicada por um colégio real, e uma média móvel apontando para o lado certo. Nada disso era o obstáculo. O obstáculo era a espera, compras de um lado e um pedido de acesso do outro, e para uma primeira passada os dois agora são um git clone e um script de setup. A versão de mim mesmo escrevendo código de tese no Octave às duas da manhã teria achado isso profundamente injusto, e teria construído alguma coisa com isso antes do café da manhã.