Cinco modelos rodaram em um turno, e eu queria ver os cinco
Eu ativei o HydraFusion na semana em que ele foi lançado, dei a ele uma tarefa real em um pequeno projeto Python e esperei cerca de um minuto. Ele voltou com uma boa resposta e um número: 14,72 créditos. Foi aí que fiquei curioso. Um modelo produziu aquilo, ou quatro? Algo foi rascunhado, revisado e melhorado ao longo do caminho? O anúncio diz que um turno pode fazer draft, critique, revise ou escalate, e que o CLI mantém rascunhos intermediários para que trabalho inacabado não pareça final. Essa é uma decisão sensata para quem está codando, porque um rascunho prestes a ser revisado não deveria ser lido como uma resposta. Também significa que a parte interessante da história acontece fora da tela, e eu queria assistir a isso.
Era isso que eu queria entender. O HydraFusion escolhe um de três padrões de execução por requisição: single, em que um modelo resolve a tarefa; cascade, em que um modelo eficiente rascunha e um quality gate decide se aceita ou escala; e critique, em que um modelo rascunha, um critic somente leitura de outra família revisa, e o drafter revisa uma vez. Cascade e critique eram os que eu queria ver, porque em ambos um segundo modelo contribuiu e o resultado ainda chega como uma resposta única e limpa. Eu queria saber qual modelo rascunhou, qual revisou, qual veredito voltou e para onde foram os créditos.
Então eu construí o samueltauil/hydrafusion-traces: docker compose up -d, aponto o CLI para ele, e cada turno aparece no Grafana com um span por fusion leg, nomeado pelo modelo que o executou.
Este é um projeto paralelo independente. Não é afiliado, endossado nem apoiado pelo GitHub ou pela Microsoft. O HydraFusion é um research preview, e tudo abaixo foi observado de fora, em uma máquina, ao longo de 24 turnos. Ele lê o session state que não carrega nenhuma promessa de compatibilidade, então vai ficar desatualizado. Nada aqui é um benchmark ou uma afirmação sobre qualidade de modelo.
Eu presumi que o OpenTelemetry simplesmente me contaria
Meu primeiro plano foi o óbvio, e estava errado.
Eu já tinha feito uma versão disso para prompt caching no copilot-traces, então presumi que o mesmo truque funcionaria. O CLI emite OpenTelemetry, eu configuraria OTEL_EXPORTER_OTLP_ENDPOINT, as fusion legs apareceriam como spans chat separados com valores diferentes de gen_ai.response.model, e eu apontaria o span-metrics generator do Tempo para esse atributo. Reservei uma noite para o projeto inteiro.
O CLI emite OTel corretamente, e é exatamente por isso que meu plano não funcionou. Cada turno chega como exatamente uma operação chat com gen_ai.request.model=hydrafusion, que é o que as GenAI semantic conventions pedem, porque gen_ai.request.model é definido como o modelo que o cliente pediu, e o cliente de fato pediu hydrafusion. Não existe um gen_ai.response.model por leg porque as conventions ainda não têm noção de um router que expande uma requisição em várias chamadas de modelo. É uma lacuna entre uma spec em desenvolvimento e uma arquitetura nova, não um defeito do CLI. O vocabulário simplesmente ainda não foi escrito.
Meu span-metrics generator, se eu o tivesse deixado rodando, teria produzido uma linda time series rotulada hydrafusion. Eu o desliguei e fui procurar em outro lugar.
Onde o detalhe realmente mora
O CLI já escreve tudo isso, por seus próprios bons motivos.
Toda sessão mantém um arquivo ~/.copilot/session-state/<id>/events.jsonl, e esse arquivo registra o padrão de routing, o plano de fases, o modelo que serviu cada fase, o veredito do revisor, tokens por fase e créditos por fase. Ele existe para que o CLI possa retomar e rebobinar uma sessão, o que é uma feature genuinamente boa e a razão pela qual esses dados são tão completos. O tailer deste repositório lê o mesmo arquivo para um segundo propósito: ele reconstrói cada turno como um trace com um span filho por leg e conta os mesmos eventos no Prometheus.
Esse é todo o truque. Todo o resto no repositório é config provisionada: um collector, Tempo, Prometheus e um dashboard do Grafana que carrega como página inicial sem login e sem configuração de datasource. O tailer é Python puro da stdlib, sem dependências, porque uma coisa que lê o seu session state deveria ser pequena o bastante para você mesmo ler.
Vale dizer quem escreveu isso. A lista de contribuidores nesse repositório tem duas entradas, eu e o Copilot. Eu fiz o spike na mão, porque descobrir o que o CLI emite significava ler linhas de JSON cru e discutir comigo mesmo sobre o que elas significavam. Tudo depois disso foi o tipo de trabalho que fico feliz em delegar: o tailer, o compose file, e várias centenas de linhas de JSON de dashboard do Grafana das quais eu teria me entediado no meio do caminho. Rodei a maior parte disso no GPT-6 Astra, que foi minha primeira sessão de verdade com esse modelo, e a coisa que notei foi o quão pouco precisei reexplicar a topologia. Qual container fala com qual porta permaneceu no lugar entre as sessões. O pull request mais recente no repositório é um do Copilot que foi lá e removeu uma feature flag HYDRAFUSION_ROLLOUT obsoleta da documentação assim que o rollout se abriu e a flag deixou de ser necessária. Isso é uma peça de manutenção pequena, chata e genuinamente útil, e eu não precisei nem notá-la sozinho.
docker compose up -d
export OTEL_EXPORTER_OTLP_ENDPOINT=http://localhost:4318
copilot --model hydrafusion
Você precisa do Copilot CLI 1.0.83 ou mais recente com /experimental on, e então selecionar o HydraFusion em /model. Se quiser dar uma olhada sem nada disso, docker compose --env-file demo.env up -d reproduz um cascade limpo já incluído em fixtures/.
Uma linha por turno nos logs do tailer diz que está funcionando:
INFO fusion fusion-fa51fa07-905f pattern=cascade phases=3 models=gpt-5.6-sol,mai-code-1.1-flash aiu=14.72
O turno de 14,72, desmontado
Aqui está o turno do início deste post, como três legs.
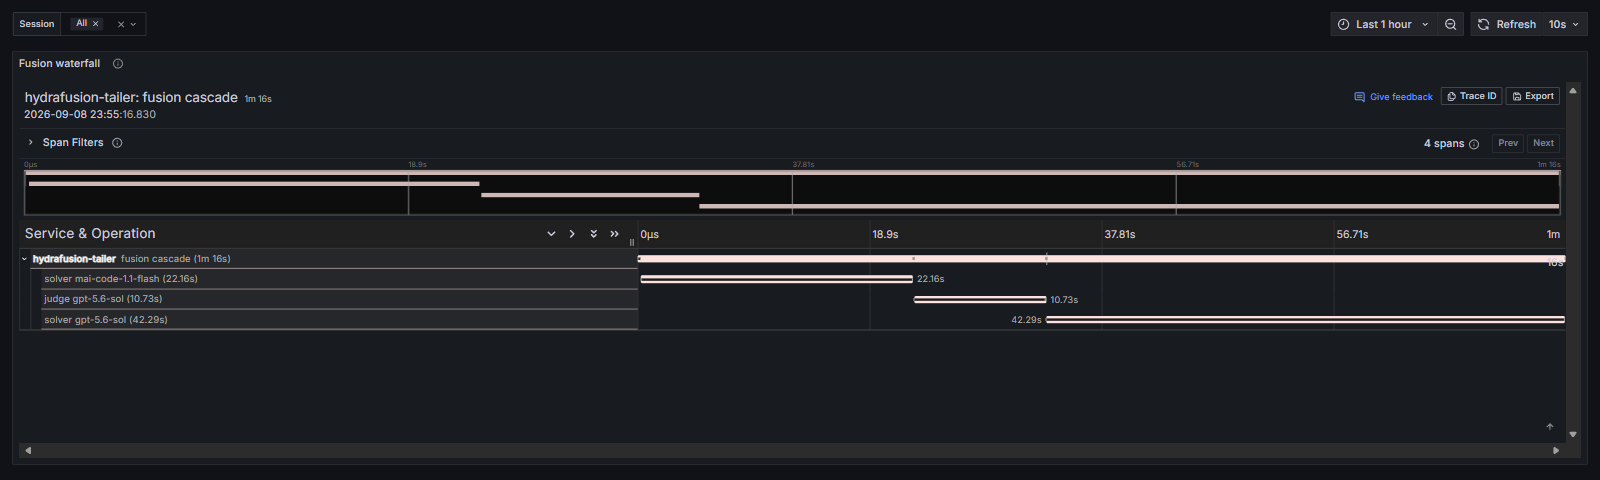
mai-code-1.1-flash rascunhou por 22 segundos e 0,58 AIU, a unidade de crédito que o CLI reporta. gpt-5.6-sol revisou esse rascunho, retornou reject, e então refez o trabalho sozinho em 42 segundos e 11,69 AIU. A leg de julgamento custou 2,46. Três legs, uma resposta coerente, e agora eu consigo ver as três.
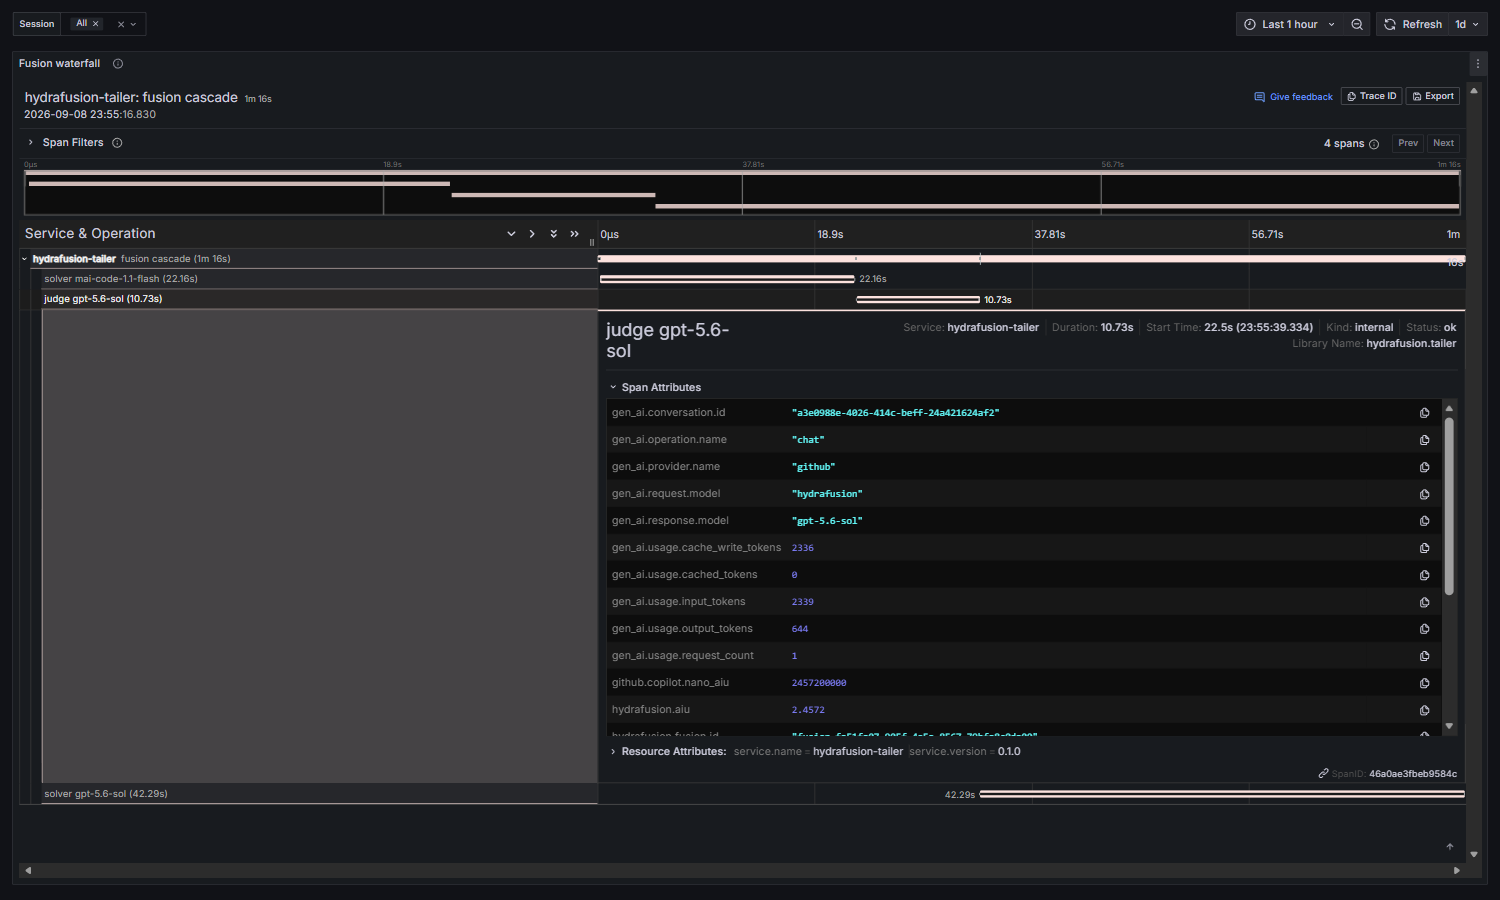
Abra qualquer leg e a história inteira cabe em duas linhas de atributos.
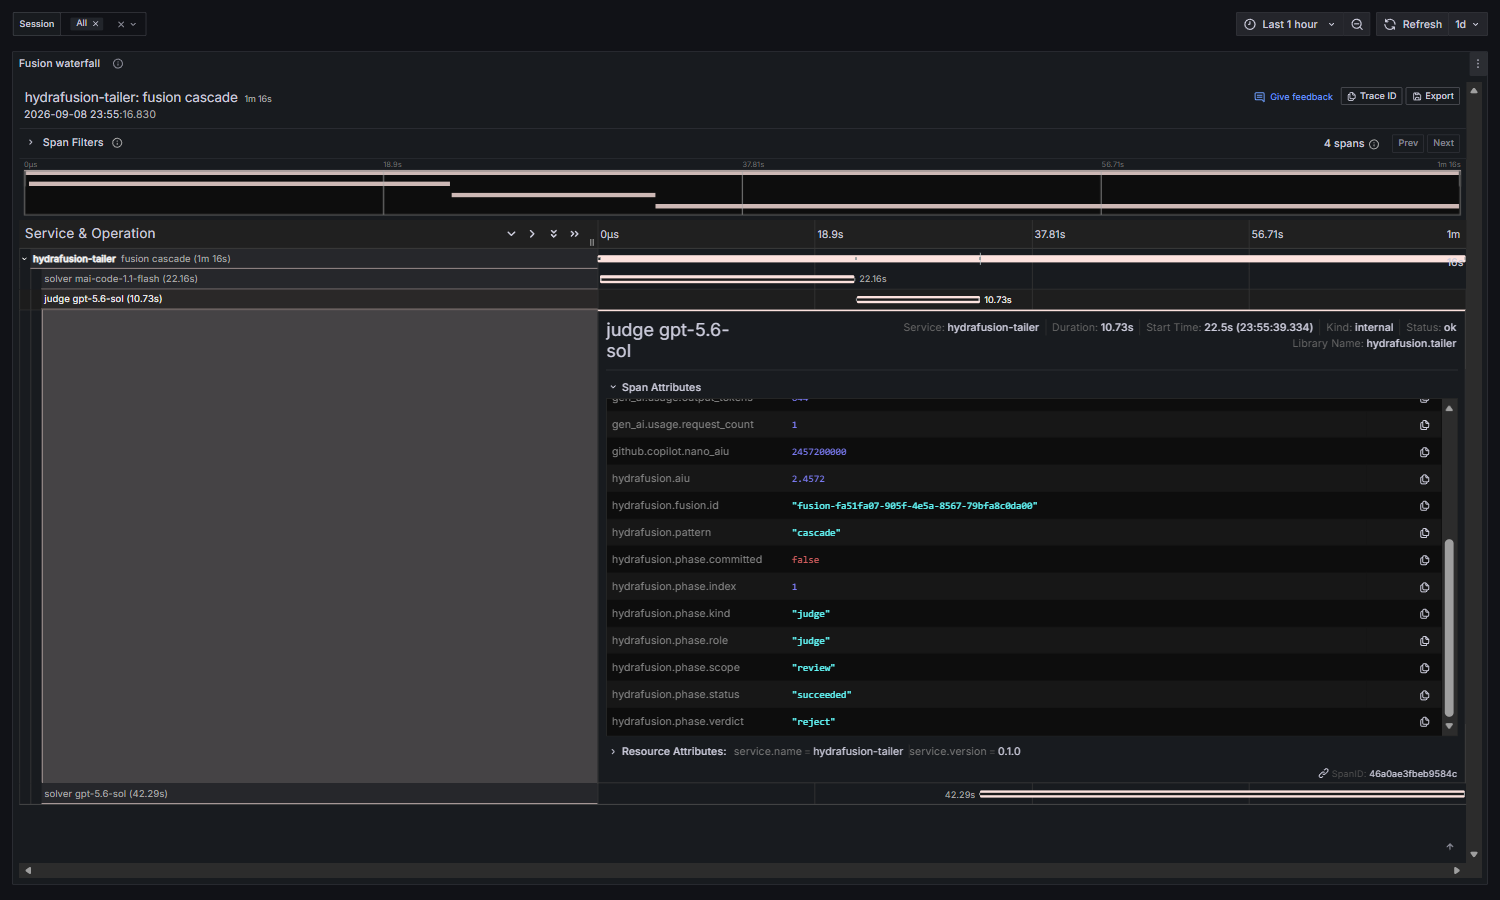
gen_ai.request.model é hydrafusion, conforme as conventions. gen_ai.response.model é gpt-5.6-sol, que o tailer adicionou a partir do log da sessão. Ambos são afirmações verdadeiras. Esse é o modelo mental ao qual eu sempre volto: as conventions presumem que uma requisição mapeia para um modelo, e um router quebra essa premissa sem quebrar nenhuma regra. O modelo que você pediu e o modelo que respondeu agora são duas coisas separadas, e a spec só tem um campo para o primeiro.
O restante da leg carrega o veredito, a divisão de tokens, o custo em créditos e uma flag indicando se essa leg produziu a resposta que você de fato recebeu.
A aposta do cascade vai nos dois sentidos
Eu escrevi uma versão inicial do documento de findings quando só tinha quatro turnos, e afirmei com confiança que todo cascade terminava em rejeição. Com 24 turnos, são dois em três, e o terceiro é mais interessante que os dois que confirmaram meu viés.
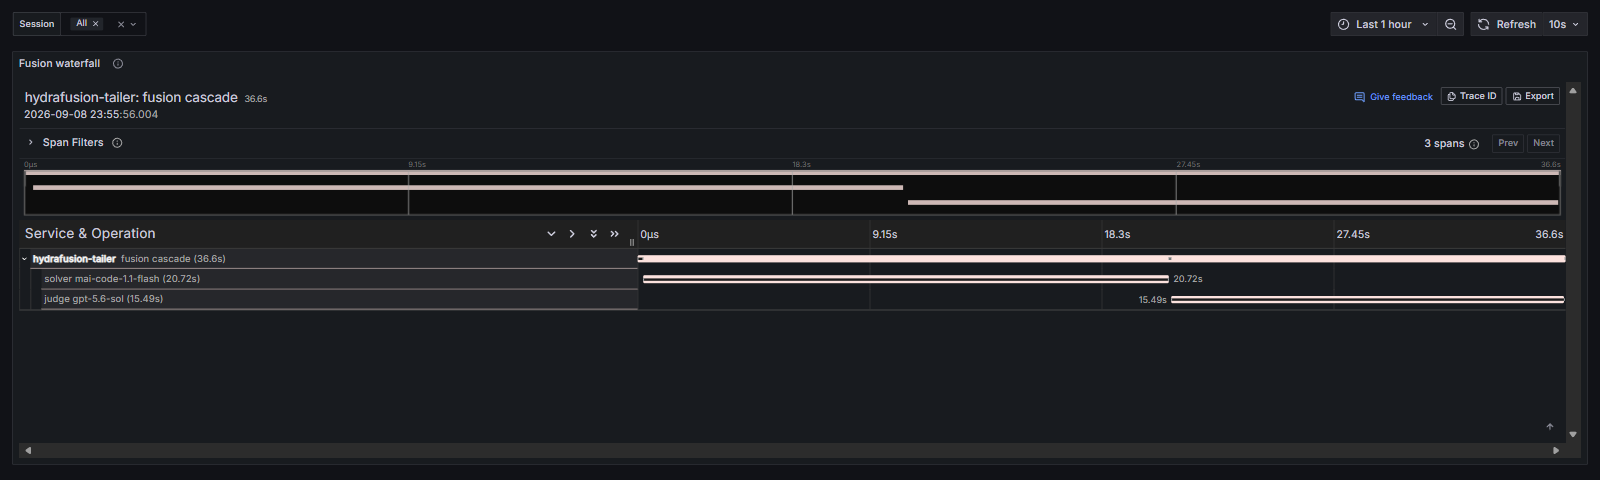
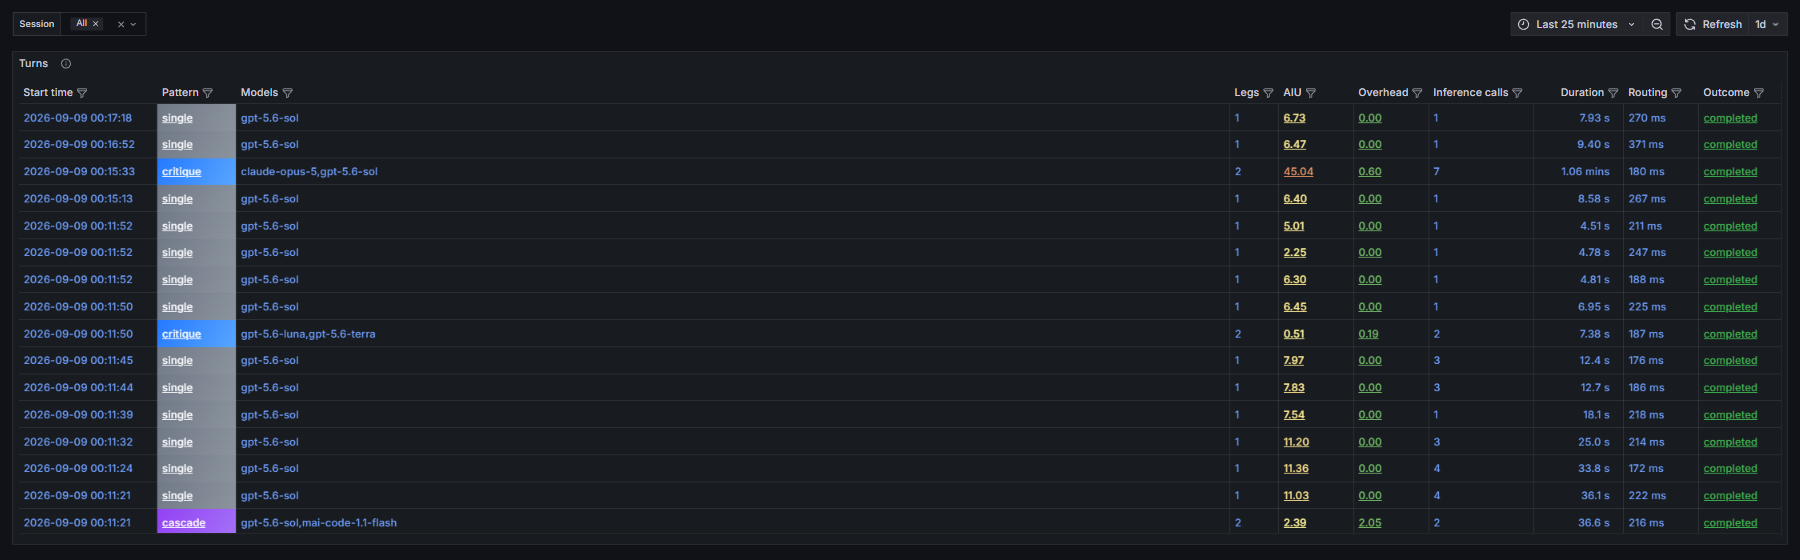
mai-code-1.1-flash respondeu uma pergunta em aberto sobre design de cache distribuído por 0,34 AIU. gpt-5.6-sol revisou e aceitou. Total do turno: 2,39 AIU, contra uma mediana de 7,97 para turnos single na mesma amostra.
Olhe a divisão interna, porém. A revisão custou 2,05 e a resposta custou 0,34. A checagem custou seis vezes o trabalho que aprovou, e o turno ainda ficou em aproximadamente um quinto de um turno single-model comparável. Acho genuinamente difícil ter uma opinião limpa sobre isso. A maior parte do gasto foi em checagem em vez de produção, e o resultado foi tanto verificado quanto mais barato que a alternativa.
Critique é um animal diferente
Cascade e critique incluem ambos uma fase de revisão, o que torna tentador agrupá-los sob o mesmo rótulo. Os traces dizem o contrário.
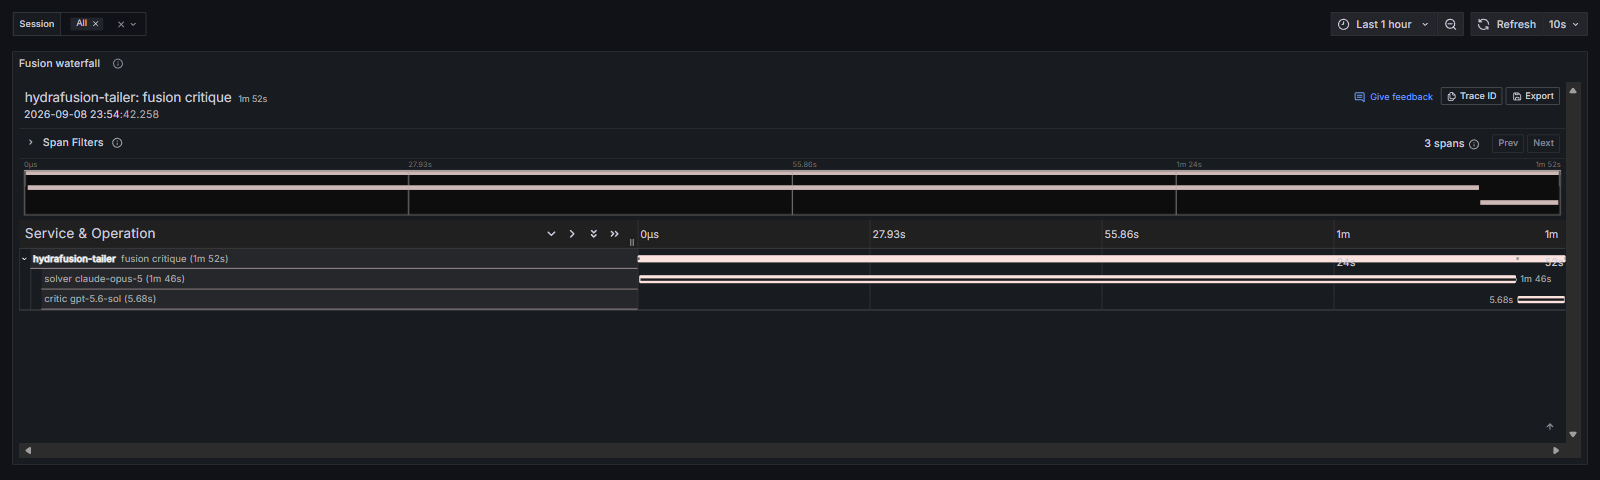
claude-opus-5 rascunhou por 1 minuto e 46 segundos e 51,11 AIU. gpt-5.6-sol fez a critique por 5,7 segundos e 0,69 AIU. Não há campo de veredito, e o rascunho é mantido como resultado final.
Então, em uma critique, a revisão é uma passagem barata sobre um trabalho caro. Em um cascade, o judge é um gate que pode disparar uma segunda tentativa completa em um modelo mais forte. Os perfis de custo vão em direções opostas mesmo que ambos os padrões incluam uma fase de revisão. Se você está construindo um modelo de custo para isso, tratar os dois como um único balde de “multi-model” vai esconder exatamente a coisa que você mais quer saber, que é com que frequência o gate dispara.
Como foram vinte e quatro turnos
Amostra pequena, uma máquina, um operador, um projetinho Python com um bug off-by-one plantado. Leia isto como um relato de campo, não uma avaliação.
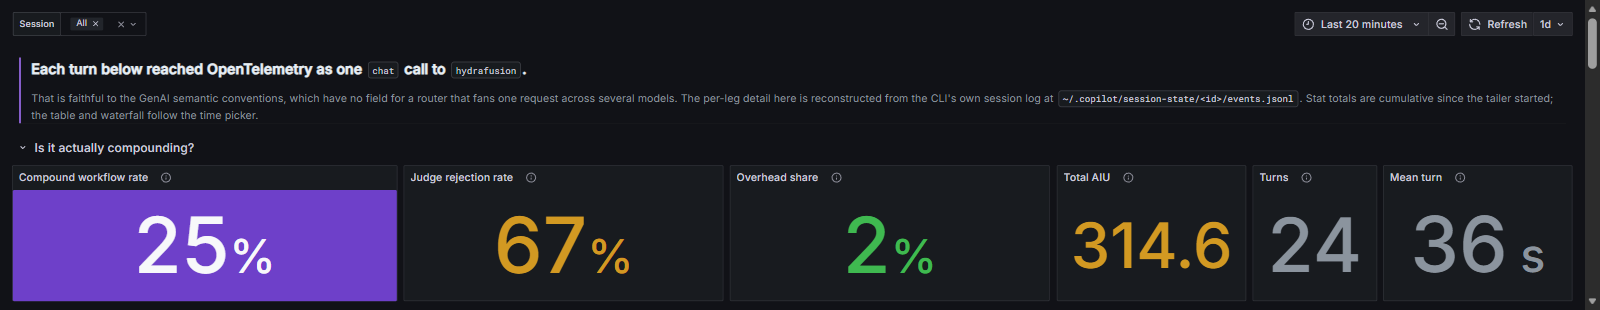
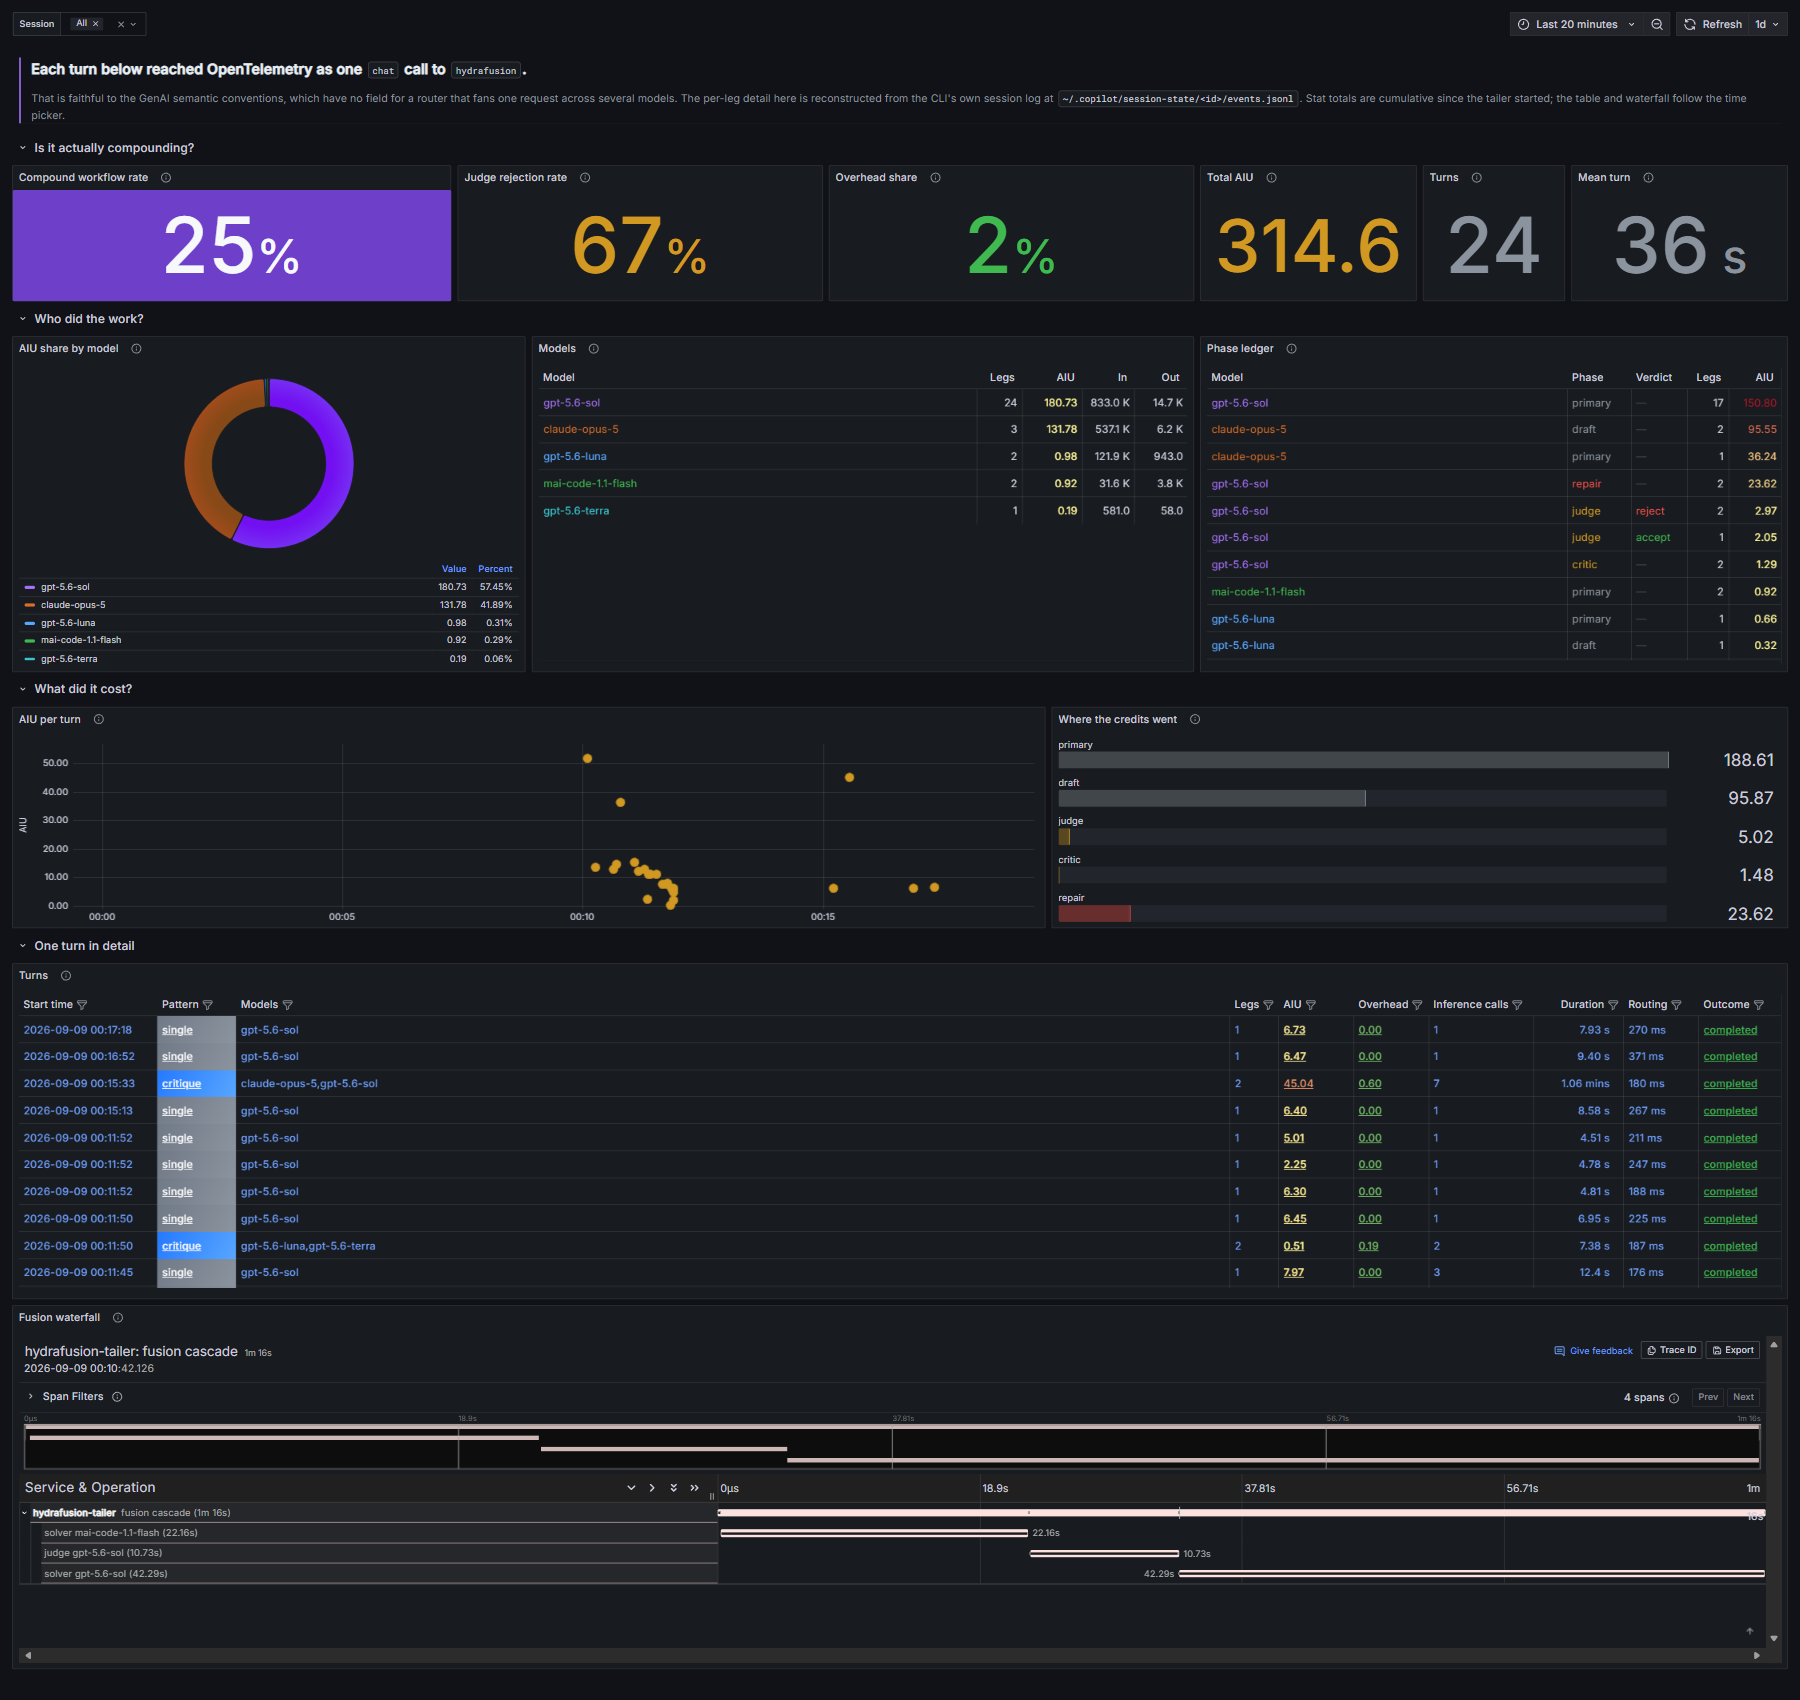
Seis dos 24 turnos usaram mais de um modelo, uma taxa composta de 25%. Dezoito turnos não tiveram segunda leg nenhuma, o que é o router decidindo que um único modelo bastava e economizando o resto. A taxa de rejeição do judge foi de 67%, embora isso seja dois em três e não um número que eu defenderia em lugar nenhum. Uma rejeição é o quality gate fazendo seu trabalho: o rascunho não passou na barra, então o turno escalou, que é exatamente o comportamento que o padrão existe para prover.
Cinco modelos distintos apareceram no conjunto.
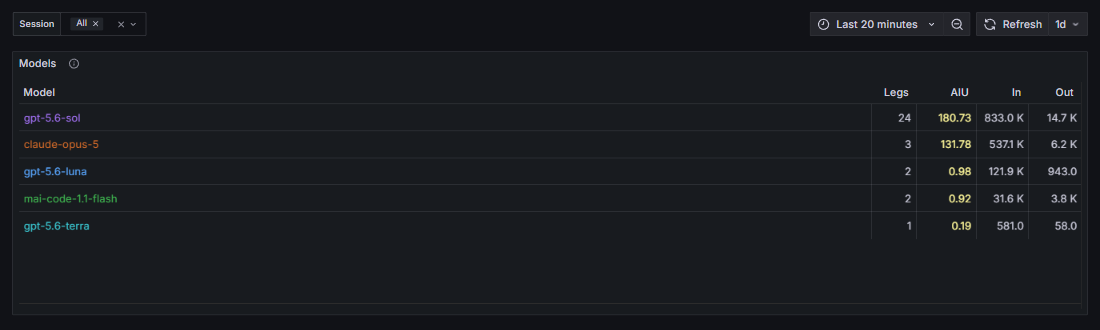
gpt-5.6-sol rodou uma leg em todos os 24 turnos. claude-opus-5 apareceu três vezes, apenas para o trabalho mais pesado: refactors em múltiplos arquivos e uma passagem de delete-and-verify.
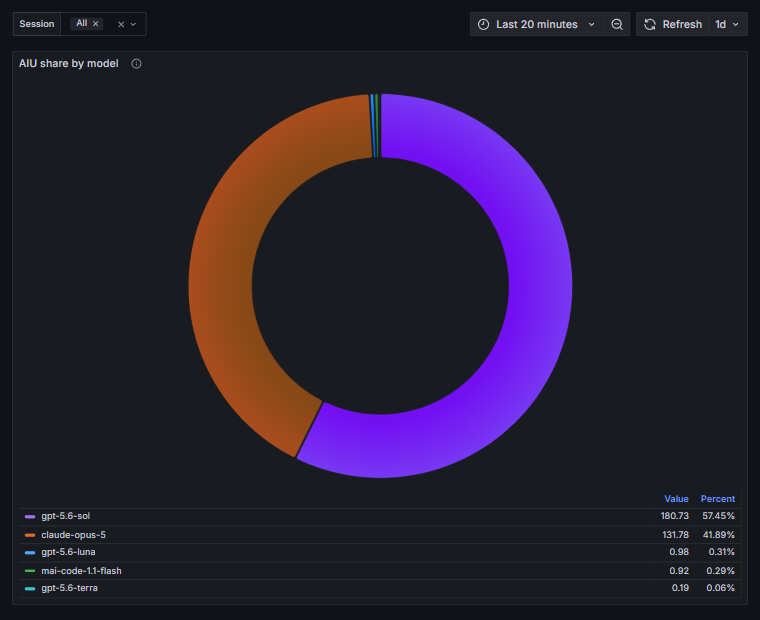
Essas três legs de claude-opus-5 tomaram 42% do gasto total. Trate os identificadores como rótulos de routing observados em um preview em vez de nomes de produto, porque eles vão mudar, e a leitura de leaderboard desse gráfico não tem sentido nesse tamanho de amostra. O ponto é que o pool é heterogêneo entre fornecedores e o router seleciona a partir dele por fase, não por sessão.
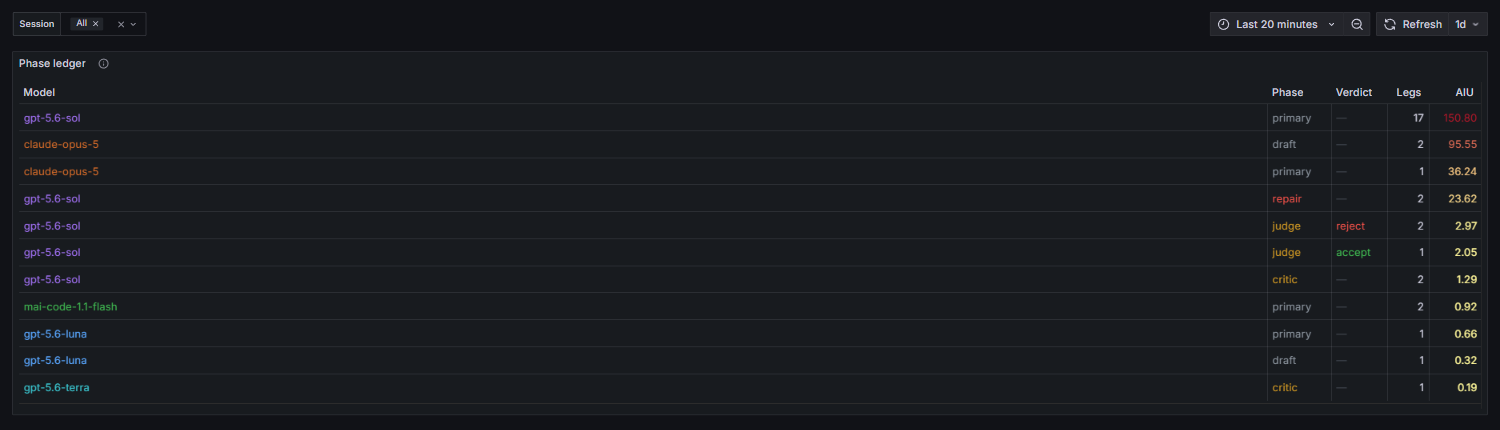
Cada leg que o router rodou, colorida por modelo e tipo de fase:
E a resposta para a pergunta que eu realmente queria saber, que é como os créditos se dividem entre a leg que respondeu e as legs que revisaram:
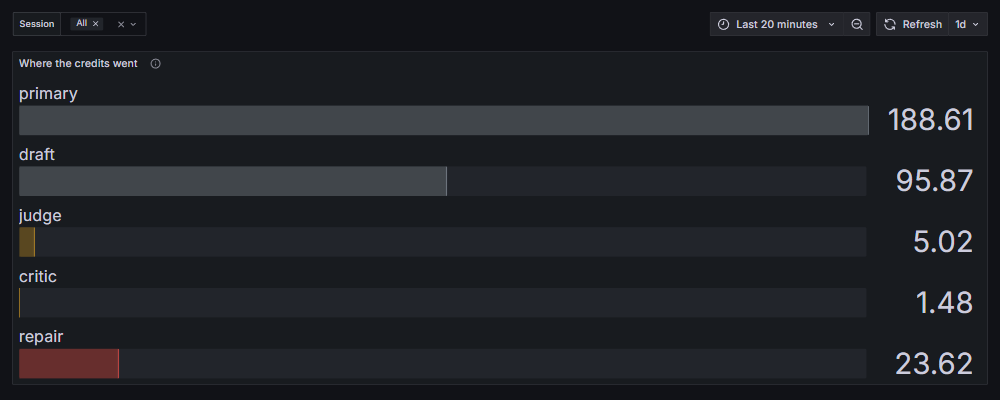
Uma leg por turno fornece a resposta que você vê. Ao longo dos 24 turnos, as legs que não fizeram isso somaram 2,5% do gasto. Hesito em chamar isso de overhead, porque um rascunho substituído e sua critique ficam no contexto da leg de reparo, então a resposta final pode muito bem ser melhor por causa da existência delas. O que esses 2,5% realmente medem é a fatia da conta que comprou revisão em vez de saída, o que é uma frase mais sem graça, mas mais defensável.
Depois, uma linha por turno, e clicar em qualquer célula carrega o waterfall daquele turno.
Acertei a rota uma vez em seis tentativas
Antes de rodar os prompts, anotei o que esperava que cada um roteasse. Minha regra era a sensata: rascunho barato para trabalho fácil, modelo forte para trabalho difícil, escalar quando o rascunho é fraco.
Acertei um em seis. Uma busca de três itens na stdlib foi para critique com dois modelos por 0,51 AIU. Um off-by-one sutil com um teste falhando, exatamente o tipo de coisa que eu esperava que disparasse um cascade, foi direto para single no modelo mais forte. Uma renomeação mecânica em dois arquivos virou um cascade. Eu errei nas duas direções e nas duas pontas da faixa de dificuldade.
Isso não significa que o routing seja arbitrário. routeSource foi capi_plan nos 24 turnos e policy foi max, o que significa que a decisão é servida remotamente e pode ser reajustada sem uma release do CLI. A seleção de padrão levou entre 172 e 371 milissegundos, uma média de 229 ms, bem abaixo de 1% dos tempos de parede de 28 a 64 segundos. Há um campo degradedReason que ficou nulo o tempo todo, então existe um caminho de fallback que eu nunca disparei.
Outras duas coisas me surpreenderam. Ao longo de 96 chamadas de inferência, os tokens de entrada superaram os de saída em cerca de 59 para 1, e três quartos dessa entrada foram servidos a partir do cache, o que é muita reutilização. A saída visível é um proxy ruim para custo aqui. Uma resposta curta com cache frio pode facilmente custar mais que uma longa, o que explica uma estranheza na tabela de turnos que fiquei encarando por um tempo antes de os números de tokens fazerem sentido.
O que vai quebrar, e quando
events.jsonl é session state, não uma API. Ele existe para que o CLI possa retomar e rebobinar, e não carrega nenhuma promessa de compatibilidade, nem deveria. Tudo aqui foi verificado contra o Copilot CLI 1.0.84-2. Quando o tailer parar de produzir linhas depois de um upgrade do CLI, é por isso, e é o resultado esperado de ler o estado interno de alguém por diversão. Os nomes de atributos também vão se mover, porque as GenAI conventions ainda estão em desenvolvimento e o CLI as acompanha, o que é a coisa certa a fazer.
Nenhum conteúdo de prompt ou resposta é capturado. O tailer lê campos de metadados e descarta corpos de mensagem, e eu deixaria OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT desligado nessa stack, porque minha stack não tem controle de acesso e armazenaria alegremente o seu código-fonte em uma porta local. Todas as portas escutam apenas em 127.0.0.1. Mantenha assim.
Nada disso é um benchmark. Vinte e quatro turnos descrevem o que a telemetria contém e provam que o dashboard funciona. Está longe de ser suficiente para julgar uma política de routing, e os números acima não dizem nada sobre qualidade de modelo.
Por que acho que esse padrão vale a pena roubar
Nada aqui está quebrado. O HydraFusion retorna uma resposta coerente por um bom motivo, o CLI reporta uma única cifra de crédito por um bom motivo, e a saída OTel é uma leitura fiel de uma spec que ainda está crescendo para modelos compostos. Cada camada se comporta exatamente como projetada, e o detalhe que eu queria estava a um arquivo de distância.
Esse é o padrão que vale a pena levar com você. Quando uma interface te dá um resumo e você quer o detalhamento, a resposta geralmente não é esperar a interface criar um campo novo. É ir procurar onde o sistema já guarda suas próprias anotações, porque a maioria dos runtimes registra muito mais do que exibe, por seus próprios motivos operacionais. Resume and rewind é a razão pela qual esse log existe, e a visibilidade de routing é um efeito colateral que ganhei de graça.
Acertei a rota uma vez em seis tentativas, o que diz muito mais sobre minha regra de bolso do que sobre o router. Esse é o argumento inteiro para ler o log em vez de raciocinar sobre ele.
O repositório é o samueltauil/hydrafusion-traces, as notas de campo estão em docs/FINDINGS.md, e o que o CLI de fato emite está medido em docs/SPIKE.md.
Atualização: registrei isso upstream
No dia seguinte à publicação deste post, transformei os achados em uma feature request no CLI: HydraFusion: emit per-phase model, verdict and credit attributes to OpenTelemetry. Fazer o tail no session state de alguém para responder uma pergunta de custo funciona, mas continua sendo um workaround, então escrevi a versão que eu preferiria ter.
O pedido é menor do que parece, porque o trabalho de instrumentação já está praticamente pronto. Todo valor que meu tailer coloca em um span é computado, nomeado e escrito em events.jsonl pelo próprio CLI. Só nunca sai do processo por um canal em que alguém possa confiar. O que propus: um child span por fase carregando gen_ai.response.model, os campos específicos do router sob um namespace github.copilot.fusion.*, o histograma de tokens já existente dimensionado pelo modelo que serviu a resposta, uma métrica de crédito ao lado dele, e algum tipo de detalhamento pós-turno no CLI para quem nunca vai levantar um collector.
O que quero upstream se resume à linha de crédito. A política de routing é servida remotamente, routeSource leu capi_plan nos 24 turnos, então a mistura pode mudar sem um release do CLI, e quem estiver observando gastos veria o número se mover sem nada para comparar. O tailer responde essa pergunta hoje, e responde bem: quatrocentas linhas de stdlib Python, 24 turns, cada decisão de routing visível. É exatamente o que eu queria dele, e é o argumento mais forte que tenho de que o dado já existe e já está correto. Essa mesma visão merece um lugar onde possa sobreviver a um formato de log e alcançar as pessoas que nunca vão levantar um collector.